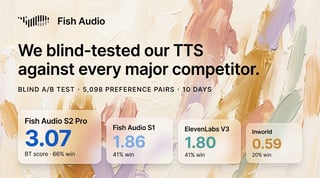
Fish Audio Drama 3:我们打造的情感表现力最强的文本转语音模型


Drama 3 是 Fish Audio 迄今为止情感表现力最强的文本转语音模型:其情感丰富度远超 S2.1 Pro,并在 Artificial Analysis 的发音稳健性(Pronunciation Robustness)基准测试中名列第一。
2026 年 10 月 13 日 | Drama 3 今日已在 fish.audio 网页端、Fish Audio 移动端应用(iOS 和 Android)以及 API 同步上线。截至 11 月 12 日:API 享 2 折优惠,新订阅创作者计划享 5 折优惠。
简而言之:
- 同样的指令,更强大的表现。 像指导 S2.1 Pro 一样给 Drama 3 指令,你会听到真实的哭腔、隐忍的愤怒,以及在强装镇定时忍不住的笑声。
- 精准遵循指令。 细语保持低声,笑声准确落位,语气随你而变,即便是在一句话的中间也能切换自如。
- 字字精准。 Drama 3 在 Artificial Analysis 的独立发音稳健性基准测试中排名第一:在针对生僻词、数字和代码的测试中,其准确率达到 93.2%,而 S2.1 Pro 为 88.1%。
- 权重开源。 你可以从 Hugging Face 自行运行 Drama 3。如果您及其关联实体的年收入低于 50 万美元,则可免费用于商业用途(遵循 Fish Audio Community License v1.0)。
在我们的发布视频中,Uncle Roger 亲自指导了他本人声音的 AI 克隆。该克隆已获得其许可制作并使用。
现在轮到你了。Uncle Roger 的声音已上线 Fish Audio,你可以亲自指导他。
同样的指令,更丰富的情感
指令写在方括号中,书写方式就像你对演员说话一样。以下是同一句台词、同一配音员和相同指令,在 S2.1 Pro 和 Drama 3 上的对比。
S2.1 Pro
Drama 3
[barely holding it together, forcing a smile] I'm fine. [shaky breath] Really. [small laugh] [whispering] Go on without me.
请留意声音颤抖时努力维持的微笑感,以及呼吸声、笑声和耳语是如何准确地出现在标记位置的。
泪水、愤怒、笑声
这些情感通常是语音模型最容易磨平的。在每段音频中,请注意第二个指令:那是声音哽咽、转为寂静或迸发出笑声的时刻。
泣不成声
[choked up, crying quietly] I left his jacket by the door. [voice breaking] I keep thinking he'll walk in and ask for it.
压抑愤怒
[through gritted teeth, keeping his voice down] I asked you to do one thing tonight. [slow, dangerously quiet] Just one.
忍俊不禁
[straight-faced, trying very hard to stay serious] No, I love it, it really suits you. [cracking up despite herself] I'm sorry, it's just a very brave haircut.
精准遵循你的指令
在情绪变化处添加新指令,演绎风格就会随之改变。
[breathless, speaking fast] Just turn off the lights. Stay away from the windows. [voice drops to a terrified whisper] And whatever you hear out there… [slow, deadly serious] <emphasis>do not open that door.</emphasis>
最后几个词位于成对标签 <emphasis>…</emphasis> 中,这只会引导起始和结束标签之间的单词。在“文本转语音”中,选中文字并从“标签”菜单中选择一个标签即可。
Drama 3 支持 83 种语言。你可以用任何你习惯的语言编写指令,指令语言不必与台词语言一致。
中文指令
[像是在强忍着眼泪,却努力笑着] I'm fine. Really. Go on without me.
西班牙语指令
[conteniendo las lágrimas, pero sonriendo] I'm fine. Really. Go on without me.
日语指令
[涙をこらえながら、無理に笑って] I'm fine. Really. Go on without me.
字字精准
只有当单词被准确还原时,丰富的情感才有意义。Artificial Analysis 独立测试了这一点:其发音稳健性基准测试将生僻词放入英语句子中(数字、代码、品牌名称以及读音取决于语境的单词),并由人类听众检查每个生僻词。Drama 3 正确读取了 93.2% 的单词,荣登排行榜榜首,而 S2.1 Pro 为 88.1%。

| 读取内容 | Drama 3 | Fish Audio S2.1 Pro |
|---|---|---|
| 品牌名、地名和专业术语 | 95.9% | 87.3% |
| 读音取决于语境的单词 | 95.3% | 86.1% |
| 速记法:数字、日期、单位、符号 | 93.6% | 92.7% |
| 精确序列:代码、路径、电子邮件 | 86.3% | 79.4% |
| 总体 | 93.2% | 88.1% |
相比 S2.1 Pro,Drama 3 进步最大的是品牌名、地名、专业术语以及多音词;文件路径和电子邮件地址等精确序列的准确率也有所提升,从 79.4% 提高到 86.3%。
Drama 3 如何学会听从指挥
语音模型——包括我们自己的 S2——通常以“易于转录”和“听起来像参考音频”作为奖励进行微调,而笑声或耳语往往会被这些评分标准扣分。Drama 3 则改用一种新的奖励方式:一个基于“人类偏好”的模型。该模型同样会处理脚本和语音,因此准确度和相似度依然重要,但它不会再因为你要求的笑声而惩罚模型。技术报告中包含更多细节。
Drama 3 的应用场景
Drama 3 在处理需要一次生成并永久保存的剧本台词时表现最佳。
- 有声书与旁白。 Drama 3 能平稳地阅读章节,并在需要的情感爆发处让声音哽咽,同时依然能准确读出“第十七章”。
- 广播剧与小说播客。 单句台词可以像上面的“开门”范例一样,从惊慌转为低语再到威胁。
- 游戏与动画。 每一句对白都能拥有专属指令:咬牙切齿的愤怒,或是忍不住的笑声。
- 短视频。 故事类视频和喜剧小品可以在网页端或 Fish Audio App 中,根据提示随时展现泪水或笑料。
“语音 AI 在生成语音方面已经非常出色。下一步是指导表演。Drama 3 是我们迄今为止最具有情感表现力和可控性的模型。它让创作者坐到了导演椅上:用通俗的语言描述你想要的效果,试听,然后只调整不满意的瞬间。这在长篇项目中尤为重要,比如有声书和多语言配音,在那类场景中,一个错词不应该意味着要重新生成整个章节。”
—— Rissa Cao,Fish Audio 联合创始人兼 CEO
自行运行 Drama 3
与 S2 一样,Drama 3 以权重开源的形式发布,因此你可以自行运行。它采用了新的许可协议 Fish Audio Community License v1.0:对于研究和非商业用途免费;如果您的年收入低于 50 万美元,则商业用途免费。超出此限额,或将 Drama 3 作为 TTS、语音克隆或推理服务/API 提供给他人,则需要获得 Fish Audio 的许可 (business@fish.audio)。该许可还禁止在未经同意的情况下克隆真实人物的声音。S2 依然遵循 Fish Audio Research License。权重和完整许可已上传至 Hugging Face,代码已上传至 GitHub。
大多数商业语音模型并不公开其构建方式。以下是 Drama 3 的运作原理:它是一个超大型模型,但每步仅使用其中的一小部分,并配有适合长剧本和多个语音片段的记忆机制。全新的音频解码器(codebook-MTP 解码器)在填充每个声音的精细纹理时,会回溯目前为止的所有内容(包括你的参考语音)。如上所述,它经过了人类偏好模型的微调。
面向开发者与研究人员

技术报告图 2。骨干网络读取系统提示、目标文本,然后是其自身的音频帧,每一帧都作为其代码 0 和 1 的融合嵌入进入。codebook-MTP 解码器在骨干网络隐藏状态的顶层运行。其四个共享层接收该状态、预测的代码 0 以及输入帧的代码 2-9(这些代码跳过骨干网络),然后 MTP 层 1-9 逐个预测剩余的代码。在下一个标记为音频帧的位置预测代码,每一层沿时间轴进行因果关注,音频分词解码器将十个代码转换为波形。
- 骨干网络(Backbone)。 35B 参数混合专家模型(MoE),每个 token 激活约 3B 参数(256 个路由专家中的 8 个加上 1 个共享专家),基于 Qwen3.5-35B-A3B 语言模型初始化。
- 混合注意力(Hybrid attention)。 40 层,由 3 个 Gated DeltaNet 层和 1 个 Gated 全注意力层组成的块构成。DeltaNet 层以恒定大小的状态携带历史信息;每四层中只有一层保留 KV 缓存。
- Codebook-MTP 解码器。 取代了 S2 的逐帧 Fast AR。四个共享层馈送九个全宽度层,每个层对应一个声学码本(1-9),且每一层在整个序列上进行因果关注,包括参考音频的精细代码。
- 部分码本融合(Partial codebook fusion)。 只有码本 0 和 1 被反馈到骨干网络(S2 反馈了全部十个),以限制曝光偏差。代码 2-9 直接进入解码器。
- 分词器(Tokenizer)。 沿用 S2 的分词器,基于 Descript Audio Codec 构建:44.1 kHz,十个码本(一个语义,九个残差),约每秒 21.5 帧,完全因果。
- 训练。 三个预训练阶段、指令微调、随后是强化学习(RL)。每个任务都以相同的 ChatML 风格格式编写为对话。
- 强化学习(RL)。 采用一个学习到的人类偏好奖励模型,无基于规则的奖励。使用不带 KL 惩罚的 GRPO,每步 1,536 个提示 × 8 个生成结果。
- 推理。 在单块 H200 上,推理引擎以每秒 271 帧的速度解码单流,而 S2 为 177 帧,尽管 Drama 3 的参数量是其七倍多。推理可通过 SGLang-Omni 实现。
技术报告中包含完整细节。
API 中的 Drama 3
本文中的所有脚本在 API 中均可直接使用。将 model 标头设置为 drama-3,并将包含标签的脚本放入 text:
curl https://api.fish.audio/v1/tts \
  -H "Authorization: Bearer <your-api-key>" \
  -H "Content-Type: application/json" \
  -H "model: drama-3" \
  -d '{
    "text": "[breathless, speaking fast] Just turn off the lights. Stay away from the windows. [voice drops to a terrified whisper] And whatever you hear out there… [slow, deadly serious] <emphasis>do not open that door.</emphasis>",
    "reference_id": "536d3a5e000945adb7038665781a4aca",
    "format": "mp3"
  }' \
  -o door.mp3
它使用与 S2.1 Pro 相同的端点,因此切换现有集成只需更改一个标头。标签和参数详见 Drama 3 文档。
即将推出
两款编辑工具正在进行小范围的邀测,编辑 API 也即将推出。以下是抢先体验。
交互式编辑
听一段生成效果,告诉 Drama 3 需要改变什么,它会结合之前的生成效果重新演绎该行。指令可以是相对的(“比那个再柔和一点”)或完全全新的。
台词:The results just came in. We didn't make it.
版本 1:沉重、沮丧的忧伤
版本 2:“比上一个更柔和、更温暖”
版本 3:“比之前更有趣一点;去掉伤感”
音频补全 (Audio Inpainting)
如果你满意某次生成,但脚本发生了变化。只需标记单词,输入新词,Drama 3 就会仅重新生成该词,并使其完美融入前后的音色、情绪和节奏中。其余部分依然是你认可的那个版本。以下是上述哭腔台词在修改一个词后的效果:
我把他的夹克 围巾 留在门口了。我总觉得他会走进来问我要。

原版本
编辑后(仅“围巾”是新生成的)
发布优惠
面向开发者: 10 月 13 日至 11 月 12 日,Drama 3 API 价格为每百万字符 10 美元,较 50 美元的原价享受 2 折优惠。
面向创作者: Drama 3 消耗的额度与 S2.1 Pro 相同。在 11 月 12 日之前,新订阅 Plus、Pro 或 Max 计划 享 5 折优惠:包括月度计划的首月,或年度计划的首年。在前 48 小时内评论我们的发布帖子,我们将赠送一个月的 Fish Audio Plus。
每次生成的效果会有所不同,建议多生成几次并保留效果最好的一条。如果生成效果没有达到你的指令要求,请在 Discord 上发布脚本;这是我们最需要的反馈。
带上你的剧本。带上你的导演思路。
常见问题解答
什么是 Fish Audio Drama 3?
Drama 3 支持哪些语言?
Drama 3 比 S2.1 Pro 好在哪里?
我该如何指导台词,或仅指导其中的部分单词?
我现在可以使用交互式编辑或音频补全功能吗?
如何通过 API 使用 Drama 3?
Drama 3 是开源的吗?可以商用吗?
Drama 3 的价格是多少?
Rissa is the CEO and co-founder of Fish Audio, pushing breakthroughs in AI voice technology. Find her latest work at @rissa_cao.
阅读Rissa Cao的更多内容
Jiahua Liu is the CTO and co-founder of Fish Audio, pushing breakthroughs in AI voice technology.
阅读Jiahua Liu的更多内容